Ce qu’un benchmark de vitesse ne dit pas sur un agent IA
Débit, latence, actions et relecture : mesurez le temps jusqu’au résultat accepté. Une méthode pour éviter de choisir un agent sur sa seule vitesse.
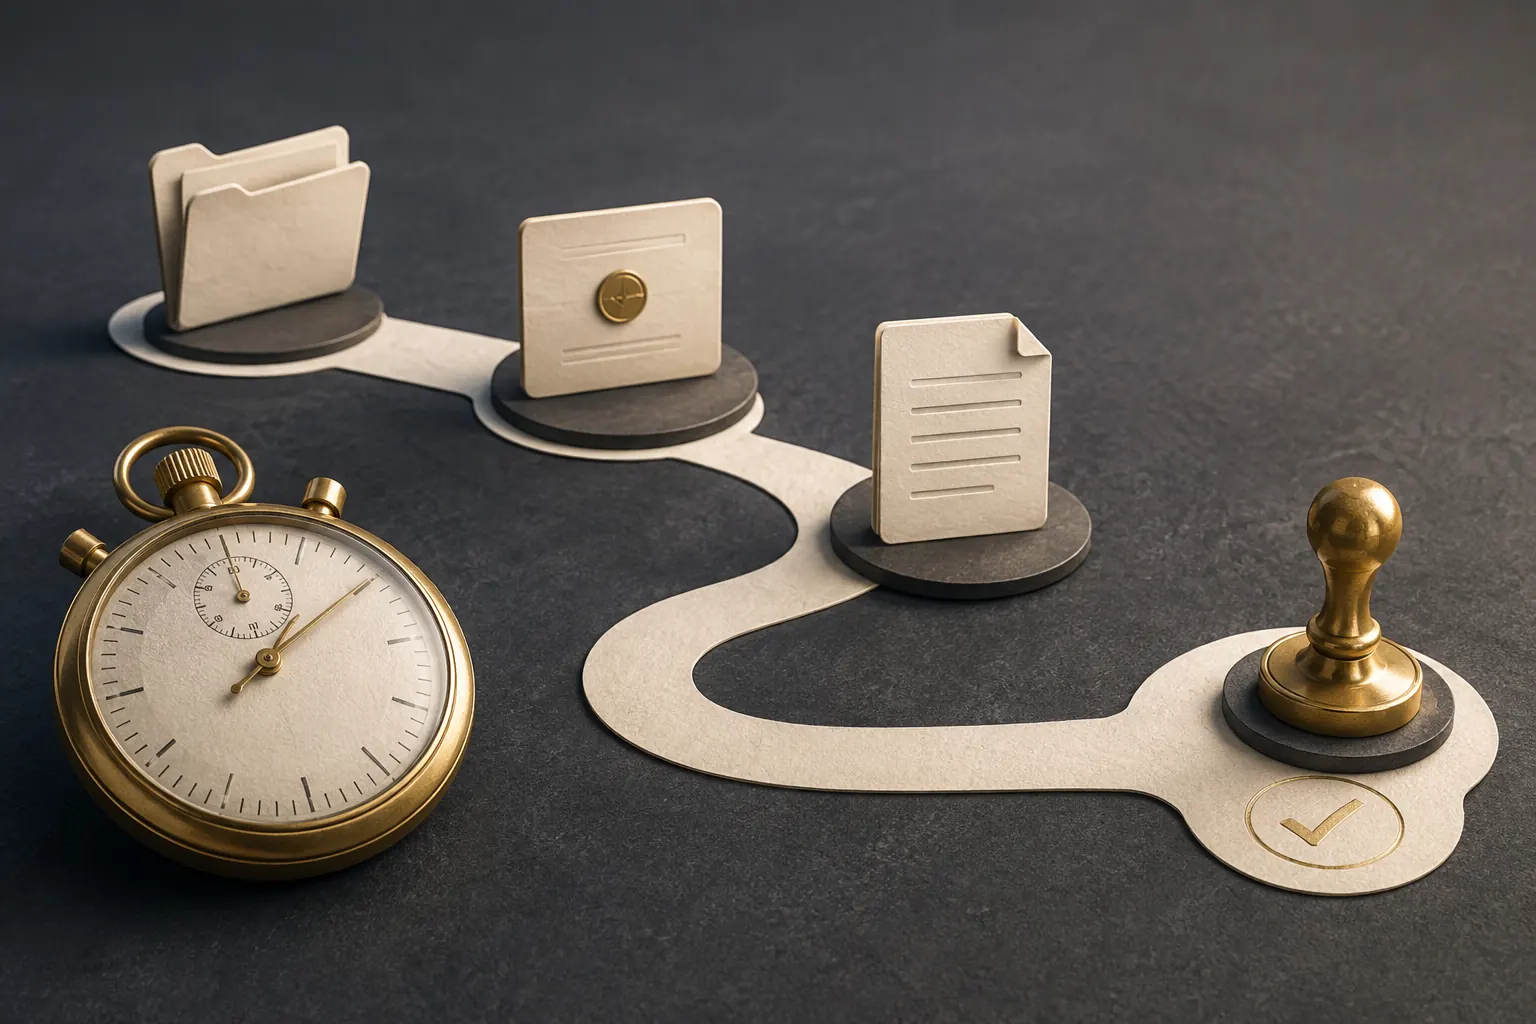
La vitesse de génération mesure une partie du travail d’un agent IA. Elle ne dit pas si la bonne source a été lue, si l’action a réussi ou combien de corrections seront nécessaires. Pour choisir une solution, je propose de mesurer le temps jusqu’au résultat que l’utilisateur accepte.
Cette mesure doit inclure les étapes réellement présentes dans le parcours. Une réponse rapide peut être utile pour une conversation ; une tâche qui consulte plusieurs outils se juge aussi sur ses attentes, ses relances et son résultat final.
Définir le début et la fin de la mesure
Exemple fictif. Un traitement reçoit une demande, consulte un dossier, prépare un document et le dépose dans un espace de travail. La personne ouvre ensuite le document et corrige deux informations.
Arrêter le chronomètre au premier mot affiché mesure la réactivité initiale. L’arrêter à la fin de la génération mesure la production du texte. L’arrêter après dépôt mesure la livraison technique. Le temps de relecture et de correction apporte encore une autre information.
Ces durées ne doivent pas être mélangées sous le seul mot « rapide ».
Une fiche de mesure du parcours
| Mesure | Question éclairée |
|---|---|
| Première réponse visible | Combien de temps l’utilisateur attend-il un premier retour ? |
| Préparation complète | Quand le traitement termine-t-il ses étapes ? |
| Livraison vérifiée | Le fichier ou l’action est-il réellement disponible ? |
| Relecture et correction | Quel travail humain reste-t-il ? |
| Résultat accepté | À quel moment la tâche répond-elle aux critères ? |
Pour un travail asynchrone, distinguez le temps actif de correction du délai avant que la personne ouvre le résultat. Attendre une validation pendant une nuit n’est pas une mesure de performance du modèle.
Conserver les conditions de l’essai
Notez la taille des documents, les outils appelés, le matériel ou le service utilisé, les paramètres disponibles et le nombre de tâches simultanées. Distinguez un premier passage d’un passage qui réutilise des éléments déjà préparés.
Rejouez les mêmes cas et gardez la dispersion des durées. Les cas lents peuvent révéler une relance, une source difficile à lire ou une attente externe. Les masquer dans une moyenne empêche de comprendre le comportement quotidien.
Si vous comparez deux configurations, expliquez ce qui change. Un modèle différent, une autre extraction et un stockage plus proche constituent une comparaison de systèmes, pas une mesure isolée du moteur de génération.
Le chapitre Monitoring Distributed Systems du livre Google SRE recommande de regarder la distribution des latences plutôt qu’une moyenne seule. Pour un agent, on peut relever la médiane et les cas les plus lents, en conservant séparément les essais échoués. Avec un petit échantillon, mieux vaut montrer les durées de chaque essai que donner une précision trompeuse à un percentile.
Compter les échecs
Un essai interrompu doit apparaître avec son état final. Un résultat livré mais refusé ne devient pas un succès parce qu’il est rapide. Présentez séparément la réussite, les erreurs et les durées des résultats acceptés.
Le coût doit être relevé lorsqu’il est effectivement disponible. On ne peut pas le déduire d’un débit seul : les entrées, les relances et les services utilisés participent aussi à la consommation.
Ce protocole aide à comparer des modèles sur une tâche réelle. Il ne remplace pas l’évaluation du contenu ; il évite de confondre un bon débit de génération avec un travail correctement terminé.
Poursuivre la lecture
Comment comparer deux modèles IA sur votre propre travail ?
Préparez un corpus, une référence et des conditions comparables. Un protocole pour choisir un modèle sur vos tâches, avec les erreurs et les limites.
Comment décider de poursuivre ou d’arrêter un essai IA ?
Un essai IA a produit des résultats : faut-il continuer ? Examinez les erreurs, les corrections et l’effort récurrent avec une grille de décision.
Une question sur votre cas précis ?
Décrivez votre besoin en deux lignes. Je vous réponds moi-même — par téléphone, en visio, ou autour d’un café en Alsace.